


















Web Scraping với Python: Ví dụ hoàn chỉnh cho người mới bắt đầu
Xây dựng scraper nhỏ bằng Python, Requests và Beautiful Soup để parse trang sản phẩm, xử lý pagination, kiểm tra dữ liệu và xuất CSV sạch.
 Tác giảYiyao
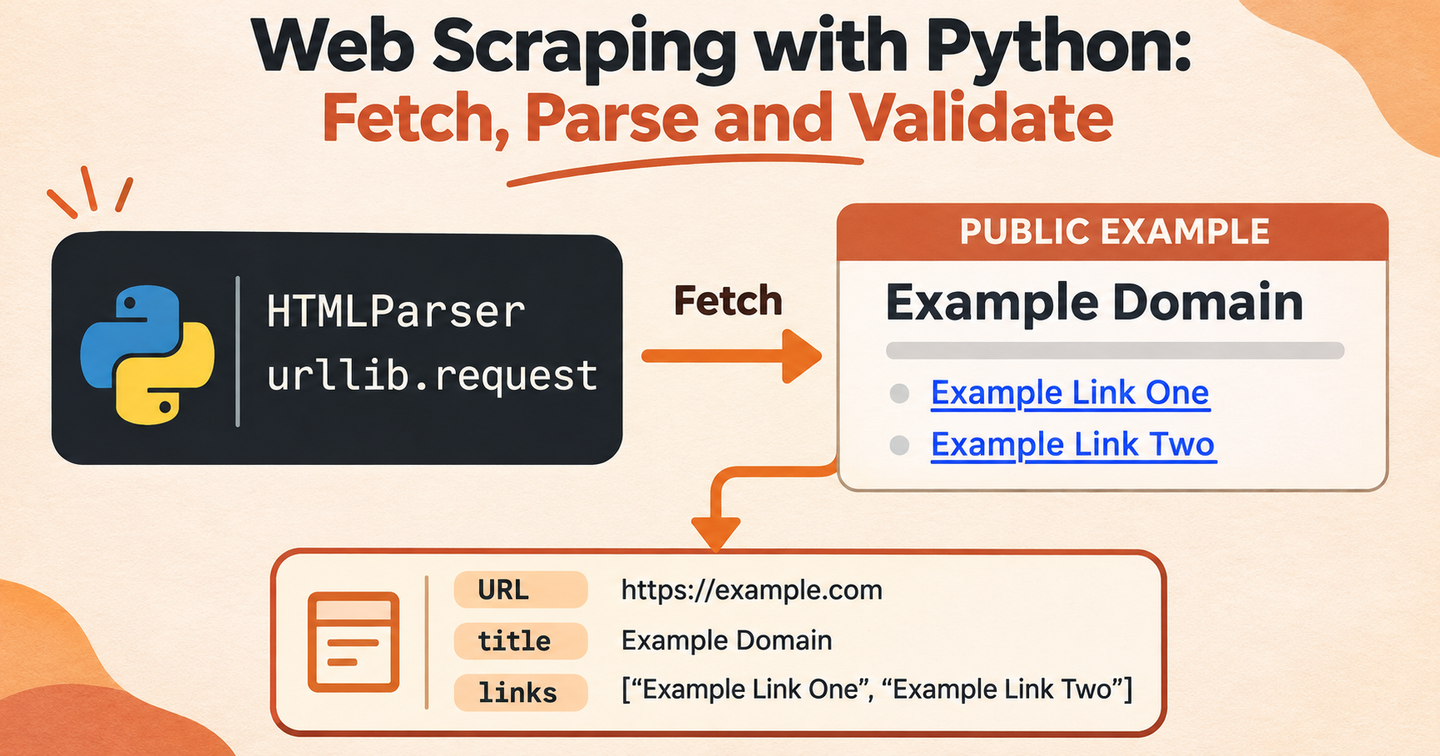
Web scraping là quá trình lấy thông tin từ các trang web được phép truy cập và chuyển thành dữ liệu có cấu trúc. Python phù hợp cho người mới bắt đầu vì Requests và Beautiful Soup giúp phần gọi HTTP và phân tích HTML dễ đọc.
Bài này dùng Books to Scrape, một website công khai được tạo riêng cho các tutorial scraping: https://books.toscrape.com/catalogue/page-1.html. Catalogue có 1.000 sách mẫu trên 50 trang. Chúng ta sẽ lấy tên sách, giá, tình trạng, số sao và URL chi tiết, sau đó mở trang chi tiết để lấy category, UPC và mô tả. Giá và rating ở đây được tạo ngẫu nhiên nên chỉ dùng cho học tập.
Trước khi thu thập: quyền truy cập, giới hạn và độ ổn định
Chỉ thu thập dữ liệu mà bạn có quyền truy cập và sử dụng. Hãy kiểm tra điều khoản của website, hướng dẫn robots.txt và luật áp dụng; tôn trọng yêu cầu đăng nhập, giới hạn tốc độ và tín hiệu yêu cầu dừng. Không nên thu thập dữ liệu cá nhân hoặc nhạy cảm nếu không có cơ sở pháp lý rõ ràng.
Một scraper tốt hoạt động như một client hợp lệ: dùng User-Agent mô tả rõ, tạo khoảng nghỉ giữa các request, đặt timeout, chỉ retry lỗi tạm thời và dừng khi website yêu cầu. Những nguyên tắc này cũng giúp pipeline của bạn ổn định hơn.
1. Cài đặt thư viện
Tạo virtual environment và cài Requests, Beautiful Soup cùng pandas. Pandas không bắt buộc cho việc parse nhưng thuận tiện khi xuất và kiểm tra dữ liệu dạng bảng.
python -m venv .venv
# macOS/Linux: source .venv/bin/activate
# Windows PowerShell: .venv\Scripts\Activate.ps1
pip install requests beautifulsoup4 pandas
2. Kiểm tra cấu trúc trang
Mở https://books.toscrape.com/catalogue/page-1.html và kiểm tra một card. Mỗi kết quả nằm trong article.product_pod. Tên và link chi tiết ở h3 a, giá ở .price_color, trạng thái ở .availability, còn rating dùng class như star-rating Four. Trang chi tiết có category trong breadcrumb, mô tả sau #product_description và UPC trong bảng table-striped.
3. Request và parse một trang
URL danh sách có quy luật: trang 1 là https://books.toscrape.com/catalogue/page-1.html và trang 2 là https://books.toscrape.com/catalogue/page-2.html. Ta sẽ tạo URL bằng tham số page thay vì giấu URL trong parser. Hàm dưới đây request một trang catalogue và lấy năm trường từ mỗi card.
from urllib.parse import urljoin

import requests
from bs4 import BeautifulSoup

BASE_URL = "https://books.toscrape.com"
HEADERS = {
    "User-Agent": "ArcvenzaBooksTutorial/1.0"
}


def page_url(page: int) -> str:
    return f"{BASE_URL}/catalogue/page-{page}.html"


def fetch_listing_page(page: int) -> list[dict]:
    response = requests.get(page_url(page), headers=HEADERS, timeout=20)
    response.raise_for_status()

    soup = BeautifulSoup(response.text, "html.parser")
    books = []

    for card in soup.select("article.product_pod"):
        title_link = card.select_one("h3 a")
        price_node = card.select_one(".price_color")
        stock_node = card.select_one(".availability")
        rating_node = card.select_one("p.star-rating")

        if not title_link or not price_node or not stock_node:
            continue

        rating = next(
            (name for name in ("One", "Two", "Three", "Four", "Five")
             if name in rating_node.get("class", [])),
            None,
        )

        books.append({
            "title": title_link.get("title") or title_link.get_text(strip=True),
            "price": price_node.get_text(strip=True),
            "availability": stock_node.get_text(" ", strip=True),
            "rating": rating,
            "url": urljoin(BASE_URL, title_link["href"]),
        })

    return books
get_text(" ", strip=True) loại bỏ khoảng trắng thừa; urljoin() chuyển liên kết tương đối thành URL đầy đủ. Việc trả về URL trang tiếp theo từ cùng hàm giúp tách phần phân trang khỏi chi tiết parse HTML.
4. Đi qua pagination an toàn
Hàm collect có các tham số thực tế: start_page chọn trang bắt đầu, max_pages giới hạn phạm vi, max_items dừng khi đủ số sách, còn min_rating lọc theo số sao. Với start_page=1 và max_pages=2, script chỉ gọi trang 1 và 2, rồi request trang chi tiết của từng sách đạt điều kiện.
from time import sleep


def fetch_detail(book: dict) -> dict:
    response = requests.get(book["url"], headers=HEADERS, timeout=20)
    response.raise_for_status()

    soup = BeautifulSoup(response.text, "html.parser")
    category_links = soup.select("ul.breadcrumb li a")
    description_node = soup.select_one("#product_description + p")
    rating_node = soup.select_one("p.star-rating")
    upc = None

    for row in soup.select("table.table-striped tr"):
        cells = row.select("th, td")
        if len(cells) == 2 and cells[0].get_text(strip=True) == "UPC":
            upc = cells[1].get_text(strip=True)
            break

    return {
        **book,
        "category": category_links[2].get_text(strip=True)
            if len(category_links) > 2 else None,
        "rating": book["rating"] or (
            next(
                (name for name in ("One", "Two", "Three", "Four", "Five")
                 if rating_node and name in rating_node.get("class", [])),
                None,
            )
        ),
        "upc": upc,
        "description": description_node.get_text(" ", strip=True)
            if description_node else None,
    }


def collect_books(
    start_page: int = 1,
    max_pages: int = 2,
    max_items: int = 40,
    min_rating: str | None = None,
) -> list[dict]:
    rating_order = {"One": 1, "Two": 2, "Three": 3, "Four": 4, "Five": 5}
    results = []

    for page in range(start_page, start_page + max_pages):
        for book in fetch_listing_page(page):
            if min_rating and rating_order.get(book["rating"], 0) < rating_order[min_rating]:
                continue

            results.append(fetch_detail(book))
            if len(results) >= max_items:
                return results

            sleep(0.8)

    return results
Khoảng nghỉ 1,5 giây trong ví dụ khá thận trọng. Trong dự án thật, hãy chọn tốc độ được website cho phép, xử lý Retry-After khi nhận 429 và ghi log URL cùng nguyên nhân lỗi.
5. Lưu dữ liệu sạch thành CSV
Mỗi dòng cuối cùng gồm title, price, availability, rating, URL, category, UPC và description. Dùng UPC làm khóa loại trùng vì tên sách trong listing có thể bị rút gọn hoặc lặp lại. File xuất là books_to_scrape.csv, có thể mở bằng Excel hoặc đọc lại bằng pandas.
import pandas as pd

books = collect_books(
    start_page=1,
    max_pages=2,
    max_items=40,
    min_rating="Four",
)

frame = pd.DataFrame(books).drop_duplicates(subset=["upc"])
frame.to_csv("books_to_scrape.csv", index=False, encoding="utf-8-sig")

print(f"Saved {len(frame)} books to books_to_scrape.csv")
Các vấn đề thường gặp
Đây là catalogue tĩnh dành cho đào tạo nên selector phải hoạt động với HTML do Requests tải về. Nếu kết quả rỗng, hãy in response.url và lưu response.text để kiểm tra. Khi đổi sang cửa hàng render bằng JavaScript, parser này chưa đủ; trước tiên cần xác định nguồn dữ liệu hoặc quy trình browser mà bạn được phép dùng. Không dùng tutorial này để vượt qua access control.
Nếu HTML không có dữ liệu nhưng trình duyệt có sản phẩm, trang có thể gọi API phía client. Trước tiên hãy xác định API đó có tài liệu hay không và bạn có được phép dùng hay không. Khi dùng endpoint, vẫn phải tuân thủ xác thực, giới hạn tốc độ, điều khoản và nguyên tắc giảm thiểu dữ liệu.
Checklist cho scraper dễ bảo trì
Đặt selector gần parser và đặt tên biến rõ nghĩa. Mọi request đều cần timeout. Ghi status code và URL. Cache response trong lúc phát triển để không gọi lặp lại cùng trang. Viết test nhỏ từ HTML đã lưu vì cấu trúc website thay đổi và parser có thể thất bại âm thầm.
Trong job production, hãy đặt URL template, selector và tên trường ở một nơi dễ bảo trì. Viết fixture test từ HTML Books to Scrape đã lưu, kiểm tra price và UPC, đồng thời ghi lại số trang khi lỗi. Demo có 1.000 record nên chạy không giới hạn sẽ gọi rất nhiều trang chi tiết; hãy bắt đầu với max_items=40 rồi mở rộng có chủ đích.
Kết luận
Một quy trình web scraping hoàn chỉnh không chỉ là một CSS selector. Python giúp bạn đi rõ ràng từ request đến parse, pagination và xuất CSV; giới hạn hợp lý cùng kiểm tra dữ liệu tạo nên kết quả đáng tin cậy. Hãy bắt đầu với một trang được phép truy cập, xác nhận dữ liệu đúng rồi mới mở rộng.