


















JSON sang CSV: Chuyển đổi bản ghi lồng nhau bằng Python
Dùng thư viện chuẩn Python để chuyển mảng object JSON thành CSV ổn định, xử lý field lồng nhau, giá trị thiếu, array, thứ tự cột, encoding và nghiệm thu.
 Tác giảYiyao
JSON sang CSV bằng Python: Ánh xạ bản ghi lồng nhau thành bảng ổn định
Khi crawler, API client hoặc job xuất dữ liệu trả về một mảng các object JSON, bước tiếp theo thường là tạo CSV để các công cụ khác có thể mở và xử lý. Tutorial này dùng riêng thư viện chuẩn của Python để xây dựng một ví dụ JSON sang CSV có thể chạy độc lập, quy định rõ ánh xạ field, giữ thứ tự cột ổn định và đưa ra cách nghiệm thu input/output lặp lại được.
Nếu bản ghi đến từ một quy trình thu thập được phép, hãy trích xuất và kiểm tra trước, rồi mới chuyển đổi như một bước riêng. Khi cần tổ chức công việc thu thập, bạn có thể xem Crawler Console của Arcvenza; script bên dưới chỉ xử lý các record có cấu trúc sau khi đã được trích xuất.
Bộ chuyển đổi phải quyết định điều gì
JSON có thể giữ object lồng nhau, array, null và các record có hình dạng khác nhau. CSV là bảng phẳng: mỗi dòng cần cùng một tập cột theo cùng thứ tự. Vì vậy, một phép chuyển đổi đáng tin cậy phải khai báo rõ path nguồn nào đi vào cột đầu ra nào.
Ví dụ này tách profile.country và profile.tier thành các cột riêng, ghi tags dưới dạng JSON compact trong một ô CSV, để trống khi thiếu field và cố định thứ tự header là id, name, profile_country, profile_tier, tags, score. Thứ tự cột là một phần của hợp đồng output, không nên phụ thuộc vào object xuất hiện đầu tiên.
Chạy một script chỉ dùng thư viện chuẩn
Lưu nội dung sau thành json_to_csv.py và chạy bằng Python 3. Input được nhúng trong script để dễ tái hiện; trong pipeline thu thập thật, hãy thay RAW_JSON bằng JSON đọc từ file hoặc response sau khi đã kiểm tra quyền truy cập và dữ liệu.
import csv
import io

records = [
    {"id": "001", "title": "Page, One",
     "source": {"url": "https://example.com/one"},
     "tags": ["guide", "public"]},
    {"id": "002", "title": "Page Two",
     "source": {"url": "https://example.com/two"},
     "tags": []},
]
buffer = io.StringIO(newline="")
writer = csv.DictWriter(
    buffer, fieldnames=["id", "title", "source_url", "tags"]
)
writer.writeheader()
for record in records:
    writer.writerow({
        "id": record["id"],
        "title": record.get("title", ""),
        "source_url": record.get("source", {}).get("url", ""),
        "tags": ";".join(record.get("tags", [])),
    })
print(buffer.getvalue(), end="")
Script tách bốn trách nhiệm: get_path đọc dotted path, csv_value áp dụng chính sách cho giá trị thiếu và giá trị lồng nhau, flatten_record dùng mapping đã khai báo, còn DictWriter giữ header và thứ tự dòng CSV. utf-8-sig hữu ích khi mở file trực tiếp bằng phần mềm bảng tính; ensure_ascii=False giữ nguyên tên tiếng Việt, tiếng Trung và các ký tự non-ASCII khác.
Output mong đợi và cách nghiệm thu
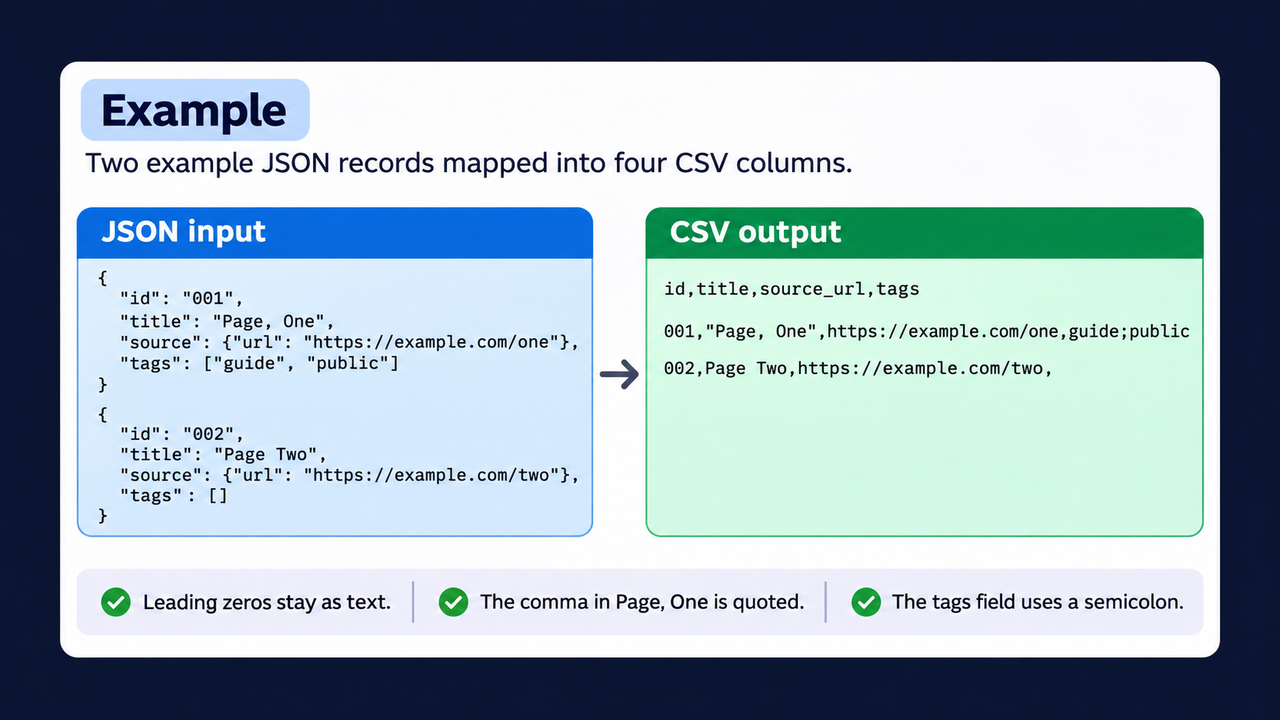
Chạy python json_to_csv.py sẽ tạo records.csv và in cùng nội dung ra màn hình. Vì JSON array compact có dấu phẩy, CSV writer sẽ tự quote ô tương ứng:
id,title,source_url,tags
001,"Page, One",https://example.com/one,guide;public
002,Page Two,https://example.com/two,
Trước khi giao file cho hệ thống tiếp theo, hãy kiểm tra các điểm sau:
- Dòng đầu tiên khớp chính xác với thứ tự cột đã khai báo.
- Số dòng dữ liệu bằng số object đầu vào.
- Path bị thiếu trở thành ô trống, còn array rỗng có chủ ý vẫn là [].
- Object và array lồng nhau được serialize thành JSON ổn định thay vì bị bỏ qua im lặng.
- Đọc lại file vẫn giữ đúng tiếng Việt và các ký tự non-ASCII; CSV reader ở downstream thấy cùng header.
Object lồng nhau, array và các chính sách thay thế
Không có một quy tắc duy nhất cho giá trị lồng nhau. Hãy flatten object nhỏ và ổn định nếu downstream cần filter theo từng field. Giữ array trong một ô khi thứ tự của nó quan trọng hoặc hệ thống sau hiểu JSON. Chỉ tách array thành nhiều dòng khi ý nghĩa nghiệp vụ là một dòng cho mỗi item; cách này làm thay đổi số dòng và phải được ghi trong data contract.
Hãy chọn chính sách cho null và field bị thiếu trước khi xuất. Chuỗi rỗng thân thiện với spreadsheet nhưng che mất khác biệt giữa “không được gửi” và “được gửi dưới dạng null”. Nếu khác biệt này quan trọng, hãy dùng token đã quy ước như NULL hoặc thêm cột biểu thị sự hiện diện.
Thứ tự cột cũng là quyết định về khả năng tương thích. Khi có thể, thêm cột mới ở cuối; nếu bắt buộc đổi tên, hãy version mapping và giữ fixture nhỏ như ba record ở trên để test. Đừng suy ra schema tạm thời từ object đứng đầu mảng.
Từ record đã trích xuất đến export production
Trong pipeline thực tế, hãy tách extraction, normalization, conversion và delivery thành các stage có thể quan sát. Tutorial web scraping với Python trước đó tập trung vào phần thu thập; tutorial này bắt đầu sau extraction, khi bạn đã có record và cần một artifact dạng bảng có thể dự đoán.
Trước một export lớn, nhất là khi record có description dài hoặc array đã serialize, hãy dùng Bandwidth Calculator để ước tính dung lượng truyền và lưu trữ. Công cụ này phục vụ capacity planning, không thay thế kiểm tra từng dòng.
Quy tắc thực tế là: giá trị scalar dùng cột phẳng; object ổn định cần query độc lập thì flatten; array vẫn là một field logic thì giữ dưới dạng JSON; chỉ tạo nhiều dòng khi mỗi item thực sự là một record. Khi chính sách này được viết rõ, JSON sang CSV trở thành một phép chuyển đổi schema có kiểm soát thay vì một thao tác format dễ làm mất dữ liệu.