


















curl 下载文件并验证结果
掌握安全的 curl 下载流程:写入临时文件,处理重定向,对 HTTP 错误失败,检查 Content-Type 与长度,校验和,谨慎断点续传,并拒绝异常内容。
 作者Yiyao
使用 curl 下载文件时,应选择本地文件名、检查响应并验证保存的内容。传输完成后,得到的应是预期文件,而不是登录页或错误文档。
保存一个已知的公开页面
下面的示例将公开的 example.com 页面保存为 example.html:
curl --fail --location --show-error --silent --max-time 30 --output example.html https://example.com/
在 Windows PowerShell 中,如果 curl 是 shell 别名,请使用 curl.exe。在应写入文件的目录中运行命令,并选择不会覆盖重要工作的文件名。
了解每个选项的作用
| 选项 | 作用 |
|---|---|
| --output | 选择本地文件名 |
| --location | 跟随 HTTP 重定向 |
| --fail | 将 HTTP 错误状态响应视为失败 |
| --max-time | 限制整个传输的时间 |
| --show-error --silent | 隐藏进度条,同时保留错误信息 |
检查下载的内容
检查文件类型、大小和预期结构。对于 HTML,检查标题和正文;对于数据集,检查表头和行数。服务器可能在状态码为 200 时返回登录页或错误消息,因此仍然必须检查内容。
将传输状态检查和文件适用性检查分开。记录最终响应位置,在可用时确认预期的 Content-Type,然后使用将要消费该文件的应用程序打开或解析它。文件名以 .csv 结尾,并不能证明保存的内容就是 CSV。
| 观察结果 | 解释 | 操作 |
|---|---|---|
| 命令报告 HTTP 错误 | 传输未达到要求的成功条件 | 检查状态和响应 |
| 文件包含登录页 | 保存的响应不是预期导出文件 | 检查已授权的下载流程 |
| CSV 表头与约定 schema 不同 | 传输成功,但内容需要复核 | 停止下游导入并比较导出版本 |
| 发布的校验和不匹配 | 文件与预期 artifact 不同 | 重新检查来源并下载后再使用 |
将传输与验证分开
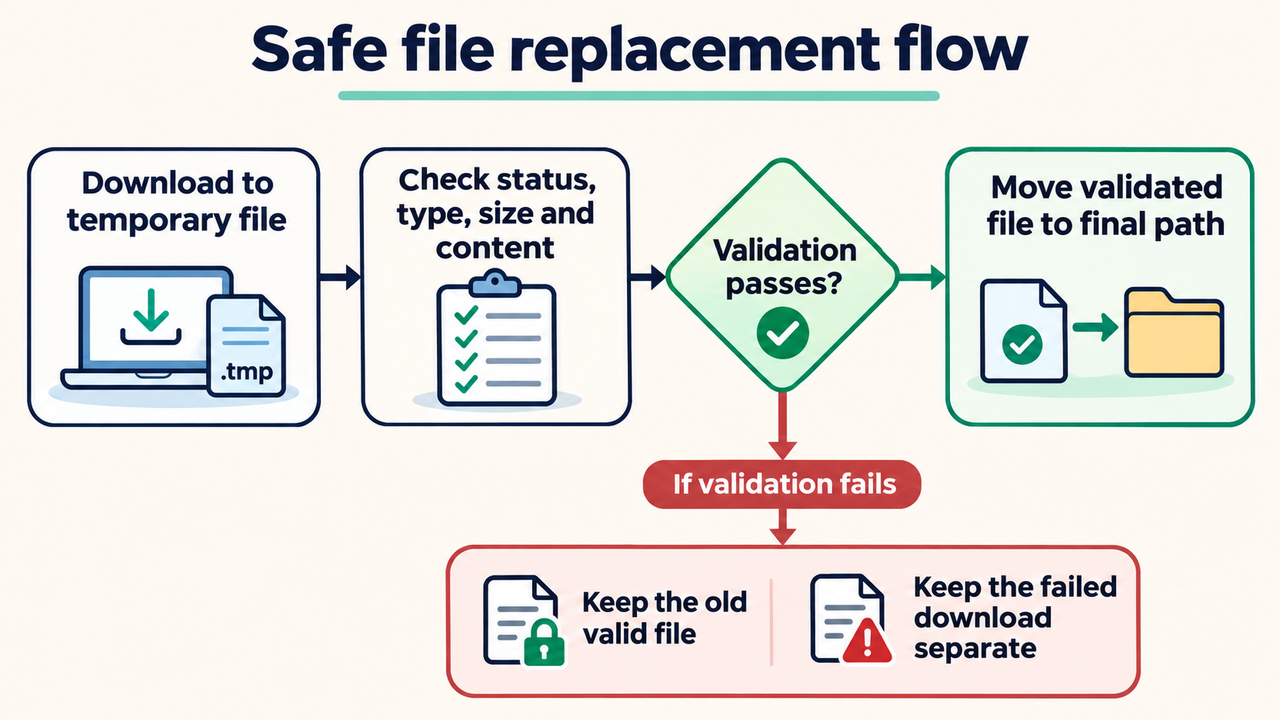
对于自动化流程,先下载到临时文件名。验证内容后,再将它移动到最终位置。在新下载通过检查前,保留之前有效的文件。
仅在来源支持时断点续传
--continue-at - 可以根据现有文件大小请求继续传输。只有在服务器支持范围请求,并且来源是同一个文件时才使用它。如果来源发生变化,请重新下载到新的临时文件并进行验证。
示例:接受一个 CSV 导出文件
下载后,检查第一行是否包含预期列,行数是否符合这次请求的合理范围。检查几条记录和注明的校验和。将来源 URL 和获取时间与文件一起保存,以便后续调查差异。
以一个示例导出交接流程为例,约定文件必须包含 record_id、source_url 和 title,并且每个来源记录对应一行数据。下载到临时文件,解析表头,在移动到导入目录前检查已知的第一条和最后一条记录。
将失败或未完成的下载与已接受的文件分开保存。如果传输发生续传,请确认来源 artifact 是同一版本,并确认服务器支持相关范围请求。续传完成后重新执行内容检查。这样可以避免仅因为文件存在于磁盘上,或上一次网络尝试没有报错,就把文件导入下游流程。
常见问题
为什么下载到的是 HTML 而不是数据?检查重定向、身份验证和最终响应内容。
curl 会执行下载的文件吗?保存内容和运行内容是两个不同的操作。打开文件前先进行检查,并使用能够执行内容的程序时保持谨慎。
参考:curl 命令手册。
继续使用合适的工作流
使用清晰的字段映射将 JSON 转换为 CSV · 使用 curl 发送 POST 请求 · 在一个控制台管理网站爬虫任务 · 探索 Crawler Console