


















SEARCH / GOOGLE
Google 搜索
采集 Google 搜索结果。
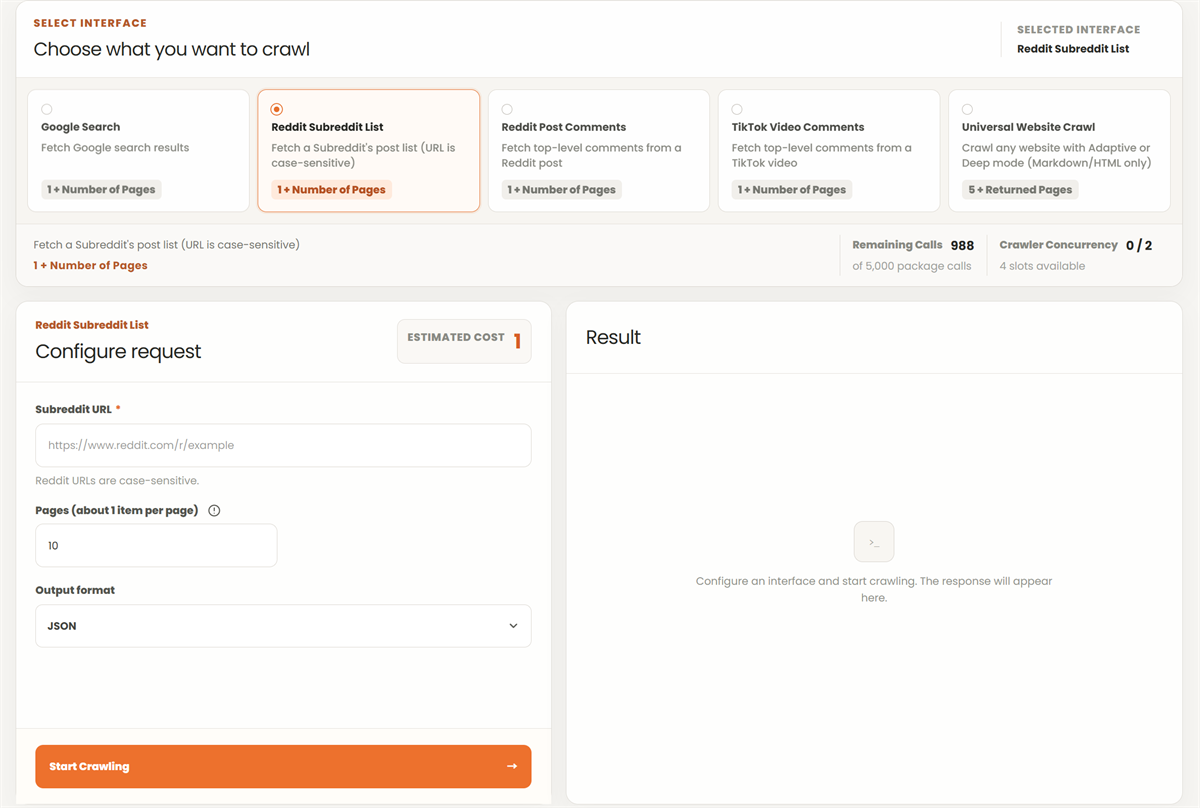
选择与目标匹配的接口。公开的产品页列出了搜索、社交评论和通用网站等选项。对于网站采集,请在当前接口中查看可用模式和输出格式。
| 任务阶段 | 操作 | 需核对的结果 |
|---|---|---|
| 01配置 | 输入目标与受支持的参数 | URL 与范围正确 |
| 02估算 | 查看显示的额度估算 | 成本依据与限制 |
| 03运行 | 提交并跟踪任务状态 | 排队中、运行中或已完成 |
| 04检查 | 打开输出与日志 | 有效内容、错误与耗时 |
采集 Google 搜索结果。
采集 subreddit 列表中的帖子。URL 区分大小写。
采集 Reddit 帖子的一级评论。
采集 TikTok 视频的一级评论。
以 alive 或 deep 模式采集网站,输出 HTML 或 Markdown。
运行任务前先写明预期输出。简短的网站评审可能只需要带 HTML 或 Markdown 输出的有限页面集合;数据管道可能还需要在采集后做额外转换。请在任务定义中把这两个阶段分开。
把预期输出变成一份别人也能执行的验收清单。对于内容清单,先确定所需的页面类型,并为每种类型挑选几个示例。即使是同一个网站,文章页、分类列表页和联系页也可能呈现不同的结构。
| 清单字段 | 获取位置 | 验收检查 |
|---|---|---|
| 来源 URL | 请求的 URL 与最终返回位置 | 记录指向提供内容的页面 |
| 页面标题 | 返回的页面内容 | 属于该页面本身,而不是通用错误页 |
| 正文 | 受支持的 HTML 或 Markdown 输出 | 包含目标板块,而不只是导航 |
| 采集结果 | 任务结果与日志 | 缺失或失败的页面被明确记录 |
| 后续动作 | 人工复核样本 | 重试、排除或调整提取规则,并注明原因 |
这些是供下游清单使用的字段。请根据所选采集接口实际返回的输出来建立映射。
使用获准的目标和适度的范围。人工检查多个页面,确认标题、正文和链接与预期内容一致。在把结果交给下游处理之前,先检查重复导航和错误页面。
保留所选接口、请求参数、任务标识符和输出位置。当结果与之前的运行不一致时,先对比输入和日志,再调整采集设计。任务完成和可用数据是两个独立的检查点。
设定获准的网站范围并选择受支持的输出。先运行一个小样本,检查实际页面,确定清单所需的字段。只有当采集和转换都能产出预期记录后,再扩大范围。
在定义完整清单之前,先走一遍小示例。假设获准范围包含一个首页、两个分类页和三篇文章。在浏览器中检查其中一篇文章,把它的标题和主要段落与采集输出进行对比。再在分类页上重复这一检查——分类页上重复的商品卡片和导航可能占满正文。
如果文章完整而分类页只有导航,请把这两种结果分开记录。写明哪种页面类型需要换一种采集或提取方式。如果来源发生了重定向,请把请求的 URL 和最终位置都记在工作记录里,方便后续检查解释这一变化。当每种所需页面类型都有明确的输出、每个被否决的条目都有清晰原因时,样本就可以扩大了。
查看任务结果和 Crawler Logs,获取请求、状态和耗时信息。
通用网站采集提供 HTML 和 Markdown 输出。请先检查实际结果,再应用下游数据集所需的转换。
当采集结果需要对比、字段映射或代码级验证时,可使用下面的指南。