


















JSON 转 CSV:使用 Python 转换嵌套记录
使用 Python 标准库把 JSON 对象数组转换为可预测的 CSV,覆盖嵌套字段、缺失值、数组、列顺序、编码与验收清单。
 作者Yiyao
使用 Python 将 JSON 转换为 CSV:把嵌套记录映射成稳定表格
当爬虫、API 客户端或导出任务返回一组 JSON 对象时,下一步通常是生成一个其他工具可以打开的 CSV 文件。本教程只使用 Python 标准库,构建一个可独立运行的 JSON 转 CSV 示例,明确字段映射、固定列顺序,并提供可重复的输入/输出验收方式。
如果记录来自合规的数据采集流程,应先完成提取与校验,再把转换作为独立步骤。需要组织采集任务时,可以了解 Arcvenza 的 Crawler Console;下面的脚本只负责处理已经提取出来的结构化记录。
转换器必须先做出的决定
JSON 可以保存嵌套对象、数组、null 和形状不完全相同的记录;CSV 则是一张扁平表格,每一行都应该拥有同一组、同一顺序的列。因此,可靠的转换必须先定义“源字段路径如何对应输出列”。
本例把 profile.country 和 profile.tier 展开成独立列,把 tags 作为紧凑 JSON 写入一个 CSV 单元格,把缺失字段写为空单元格,并将列顺序固定为 id、name、profile_country、profile_tier、tags、score。列顺序属于输出契约,不能依赖输入数组中第一个对象的字段顺序。
使用标准库编写可独立运行的脚本
将下面内容保存为 json_to_csv.py,并使用 Python 3 运行。为了方便复现,示例把输入 JSON 放在脚本中;在实际采集管道里,应在完成权限和数据校验后,把 RAW_JSON 替换成文件或响应中的 JSON 文本。
import csv
import io

records = [
    {"id": "001", "title": "Page, One",
     "source": {"url": "https://example.com/one"},
     "tags": ["guide", "public"]},
    {"id": "002", "title": "Page Two",
     "source": {"url": "https://example.com/two"},
     "tags": []},
]
buffer = io.StringIO(newline="")
writer = csv.DictWriter(
    buffer, fieldnames=["id", "title", "source_url", "tags"]
)
writer.writeheader()
for record in records:
    writer.writerow({
        "id": record["id"],
        "title": record.get("title", ""),
        "source_url": record.get("source", {}).get("url", ""),
        "tags": ";".join(record.get("tags", [])),
    })
print(buffer.getvalue(), end="")
脚本把职责拆成四部分:get_path 读取点号路径,csv_value 执行缺失值和嵌套值策略,flatten_record 应用声明式映射,DictWriter 负责 CSV 的表头和行顺序。utf-8-sig 适合直接用表格软件打开;ensure_ascii=False 则能保留可读的中文和其他非 ASCII 字符。
预期输出与验收
运行 python json_to_csv.py 会创建 records.csv 并打印同样的内容。由于紧凑 JSON 数组包含逗号,CSV writer 会自动为对应单元格加引号:
id,title,source_url,tags
001,"Page, One",https://example.com/one,guide;public
002,Page Two,https://example.com/two,
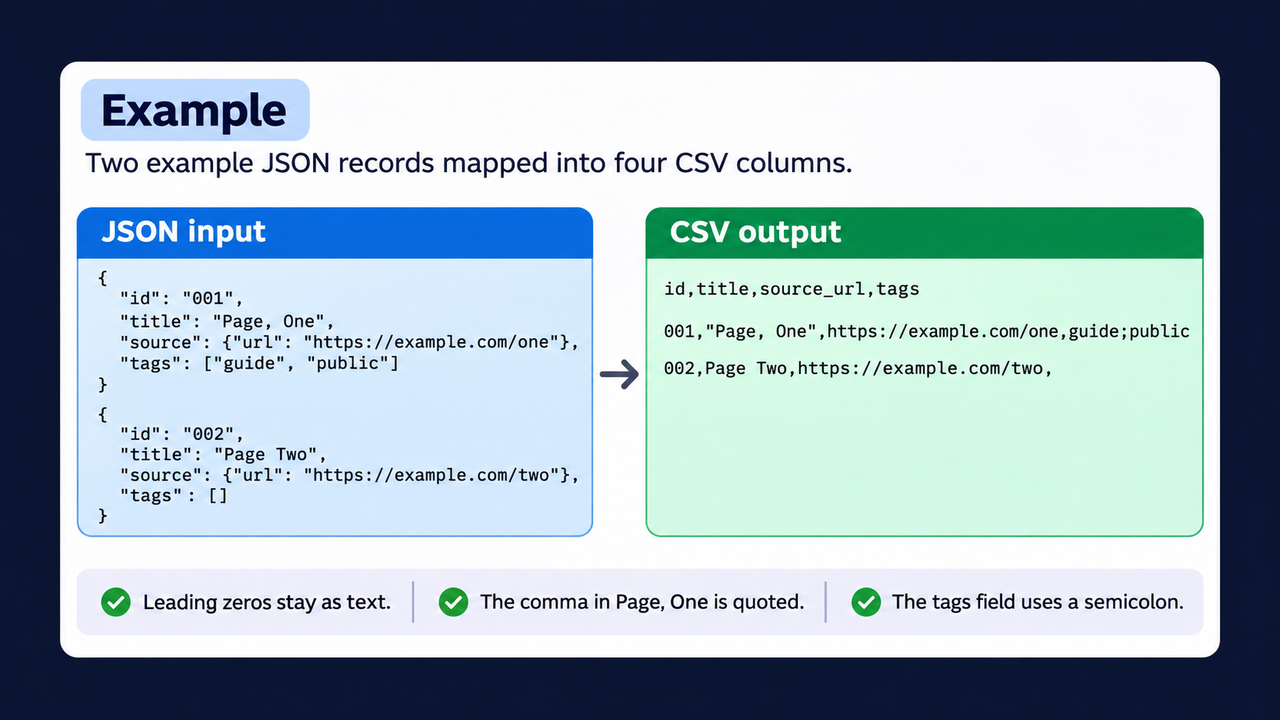
把文件交给下游系统前,可以按下面的清单验收:
- 第一行与声明的列顺序完全一致。
- 数据行数量等于输入对象数量。
- 缺失路径变为空单元格;有意提供的空数组仍然是 []。
- 嵌套对象和数组被确定性地序列化为 JSON,没有被静默丢弃。
- 回读文件时中文等非 ASCII 文本仍然正确,下游 CSV reader 读取到的表头相同。
嵌套对象、数组与其他处理策略
嵌套值没有唯一正确的处理规则。下游需要按字段筛选时,可以把小而稳定的对象展开成列;数组顺序有意义,或下游能够理解 JSON 时,可以把数组保留在一个单元格中。只有当业务含义是“一项数组元素对应一行”时,才应把数组拆成多行,因为这会改变行数,必须写入数据契约。
导出前也要明确 null 与字段缺失的策略。空字符串适合表格软件,但会隐藏“没有提供”和“明确提供 null”之间的区别。如果这个区别重要,应使用约定好的 NULL 标记,或增加单独的存在性列。
列顺序同样是兼容性决策。条件允许时把新增列追加到末尾;无法避免重命名时给映射版本化,并保留像上面三条记录这样的固定 fixture 做测试。不要根据恰好排在第一位的对象临时推断 schema。
从提取记录到生产级导出
在真实管道中,应把提取、规范化、转换和交付拆成可观察的阶段。此前的 Python 网页数据采集教程 介绍采集环节;本教程从已经拿到记录开始,重点是生成可预测的表格产物。
大型导出前,尤其是记录包含长简介或序列化数组时,可以使用 Bandwidth Calculator 估算传输和存储容量。它适合容量规划,不能替代逐行校验。
实用的判断规则是:标量值使用普通列;需要独立查询的稳定对象展开成列;仍属于一个逻辑字段的数组保留为 JSON;只有当数组元素本身就是记录时才拆成多行。把这个策略写清楚后,JSON 转 CSV 就是一次受控的 schema 转换,而不是可能丢失信息的格式化操作。