





















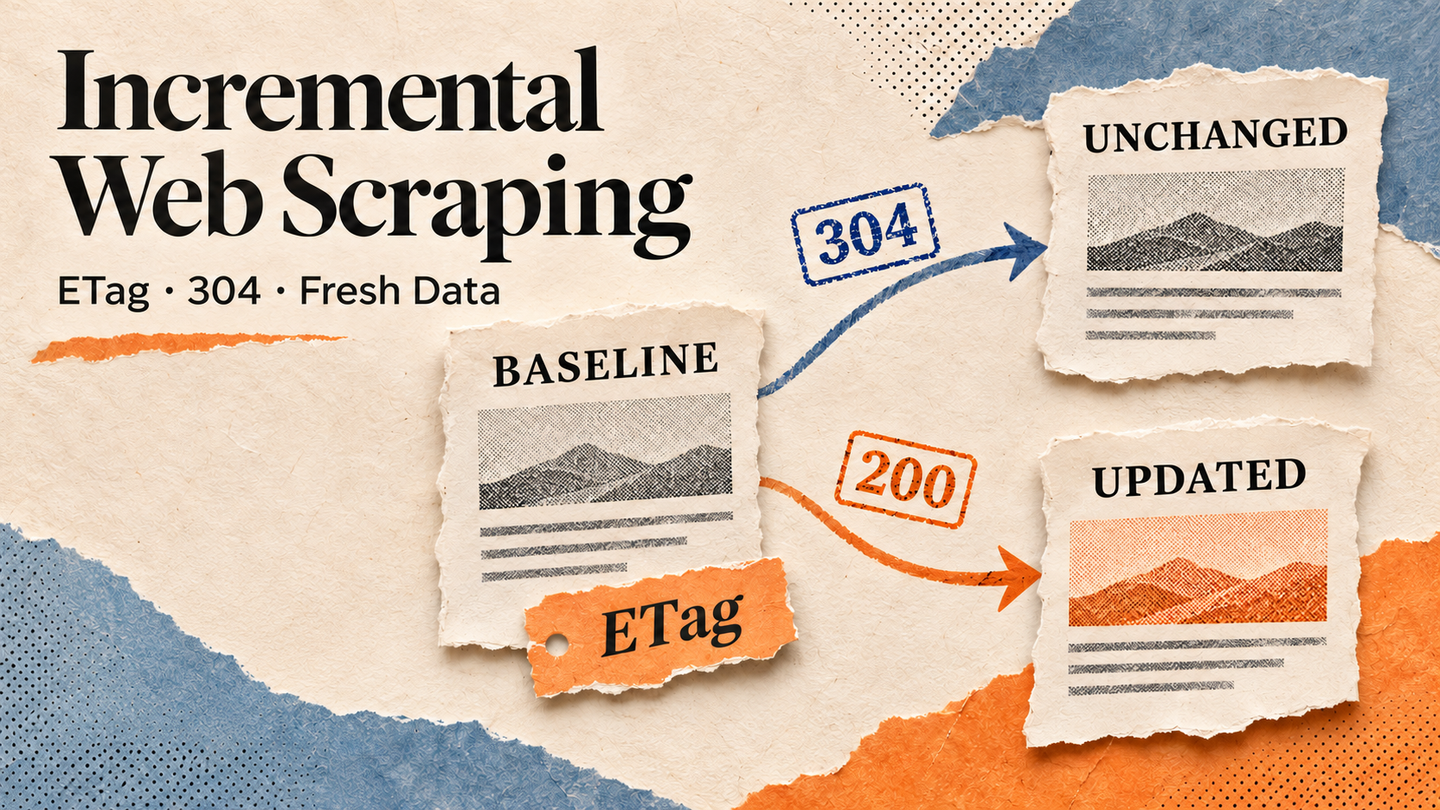
网页采集任务即使请求全部成功,也可能产出过期或误导性数据。每次重抓所有 URL 会浪费传输与解析成本;把每次响应都当作更新,又会放大下游处理量。增量网页抓取要回答的是一个更精确的问题:在已获准访问的 URL、指定地区及请求语境下,当前选中的网页表示是否不同于上次经验证的观测?HTTP 验证器能提供第一层信号,但最终含义仍取决于采集契约和已保存的基线。
TL;DR — 按 URL 与请求语境分别保存有效基线。来源提供 ETag 或 Last-Modified 时使用条件 GET;有效的 304 应沿用原有表示,200 则需解析并核对后才能宣布有业务变化。地区、语言和会话变体不可共用验证器;疑似删除须复核,并遵守来源的访问限制。Arcvenza 住宅代理可提供适合地区观测的网络路径,Crawler Console 可协助组织爬取任务;变更判断仍由采集程序负责。
1. 先定义数据新鲜度,再优化请求
先写清数据集契约,而不是先选择代理池:允许访问的来源路径、实体主键、目标字段、地区、语言、观测间隔和可接受延迟。价格监控可能需要价格、币种、卖家、库存和时间戳;文档监控可能只关心正文。相同的字节变化,对两种任务的意义并不相同。首次运行应保存完整快照和实际观测时间;若初始基线陈旧或不完整,后续的“未变化”结论便不可靠。
应区分三种信号:传输层新鲜度,即何时检查过来源;表示层变化,即响应字节或验证器是否改变;业务层变化,即所需字段是否改变。304 能说明在该条件请求中,所选 HTTP 表示仍可沿用,却不能证明所有地区的商品都有库存,也不能证明页面背后的动态 API 毫无变化。如果 HTML 外壳与数据接口分离,应追踪真正承载目标字段的表示。
一条可审计的记录至少包括来源 URL、标准化实体 ID、请求语境、采集时间、响应状态、验证器、内容摘要、解析器版本和通过校验的字段。只有新观测通过质量检查,才应替换上一条有效记录。请求失败应记为状态未知,而不能伪装成“无变化”。
2. 用 HTTP 验证器做条件检查
依据 RFC 9110《HTTP 语义》,服务器可在 200 响应中返回 ETag 或 Last-Modified。下次 GET 可将已保存的 ETag 放入 If-None-Match;没有 ETag 时,再用修改时间构造 If-Modified-Since。若所选表示未变,304 Not Modified 表示客户端应复用已存表示,响应没有可重新解析的正文;若已变,服务器可返回新的 200 与内容。两个条件头同时存在时,If-None-Match 优先,因此下文示例只选择其中一个。
ETag 可能是强验证器,也可能是弱验证器;它是来源给出的表示标识,并不等同于目标字段的语义差异。Last-Modified 的时间精度通常较粗,可能漏掉短时间内的更新;有些来源还会省略或不一致地实现这些响应头。因此应先用小样本验证实际行为,再估计可节约的流量。CDN 或中间缓存也可能参与重新验证;排查异常 304 时,要保留响应头和网络路径信息。
包括 Vary 在内的 HTTP 缓存规则说明:只有匹配请求变体,已存响应才能复用。不要把一个语言或会话中拿到的 ETag 交给另一个语境,再把 304 解释为全球统一的“无变化”。内容协商和个性化响应可能让相同 URL 呈现不同内容。
| 响应 | 可以得出的结论 | 状态处理 | 不能推断 |
|---|---|---|---|
| 304 Not Modified | 该请求中的所选表示通过已存基线验证 | 保留基线;更新检查时间及相关元数据 | 所有地区或隐藏接口均未变化 |
| 200 OK | 来源返回了一个表示 | 校验字段、比较摘要与业务字段,再更新基线 | 任意字节差异都是业务变化 |
| 404 / 410 | 此语境中的资源不可用或被报告移除 | 标记待同语境复核并检查来源 | 单次响应证明永久删除 |
| 429 Too Many Requests | 来源实施了限流 | 暂停;若提供 Retry-After 则遵从 | 更换 IP 就可以继续请求 |
3. 按地区与会话语境隔离基线
采集系统的状态键通常不止 URL。应纳入路径与查询参数、目标市场或出口地区、语言、相关请求头、访问范围,以及影响所选表示的会话状态。遵从来源的 Vary 响应头,但也不能认为它穷尽了所有应用层差异。币种选择、配送邮编、登录状态或同意设置,即使 URL 不变,也可能改变页面。应把它们记为不同的采样语境,并在数据输出中说明。
对于已获准进行的地区观测,Arcvenza 住宅代理的地区与会话控制可帮助网络出口与目标市场保持一致。先选择并验证实际出口位置,再在可比较的时间序列中维持网络路径与应用语境一致。代理只改变网络路径;它不保证网站一定返回预期语言,也不会自动完成条件请求或变更检测。
每一组验证器都应存放在完整语境键下。如果会话过期、出口市场变动,或网站开始返回其他页面变体,应建立新基线,而非复用旧摘要。无论收到 304 还是 200,都要核对实际语言、币种和实体 ID,之后才能把观测纳入对应市场序列。网站按地域重定向,或首次访问时设置市场 Cookie 的场景尤其需要如此。
4. 实现一个小型条件抓取循环
下面的 Python Requests 示例展示单个获准访问 URL 的关键分支。为便于阅读,它用内存字典表示状态;生产环境应换成持久、原子性的存储,并增加调度、结构化日志和针对来源的解析器。只有经授权的采集方案确实需要代理时,才设置 PROXY_URL。示例关闭环境中隐含的代理配置,使出口选择明确;同时设置连接和读取超时,并在检查目标地址前不自动跟随重定向。
import hashlib
import os
import requests

URL = "https://example.com/"  # Replace with a permitted source URL
CONTEXT = ("US", "en-US", "public")  # Market, language, access scope
state = {}  # Teaching demo; use durable storage in production
key = (URL, *CONTEXT)
proxy_url = os.getenv("PROXY_URL")  # Optional; keep secrets out of logs
proxies = {"http": proxy_url, "https": proxy_url} if proxy_url else {}


def fetch_once(session):
    old = state.get(key, {})
    headers = {"Accept-Language": CONTEXT[1]}
    if old.get("etag"):
        headers["If-None-Match"] = old["etag"]
    elif old.get("last_modified"):
        headers["If-Modified-Since"] = old["last_modified"]

    response = session.get(
        URL, headers=headers, proxies=proxies,
        timeout=(5, 20), allow_redirects=False,
    )
    if response.status_code == 304:
        if "body" not in old:
            raise RuntimeError("304 without a stored representation")
        print("unchanged; retained bytes:", len(old["body"]))
    elif response.status_code == 200:
        body = response.content
        digest = hashlib.sha256(body).hexdigest()
        print("changed:", digest != old.get("sha256"))
        # Validate parsed fields before saving a production baseline.
        state[key] = {
            "body": body, "sha256": digest,
            "etag": response.headers.get("ETag"),
            "last_modified": response.headers.get("Last-Modified"),
        }
    elif response.status_code == 429:
        raise RuntimeError("Rate limited: honor Retry-After and pause")
    elif response.status_code in (404, 410):
        raise RuntimeError("Possible removal: confirm in the same context")
    else:
        response.raise_for_status()
        raise RuntimeError(f"Unexpected status: {response.status_code}")


with requests.Session() as session:
    session.trust_env = False
    fetch_once(session)  # First observation
    fetch_once(session)  # Teaching demo; schedule future checks responsibly
关于 Session 和代理配置,参见 Requests 官方进阶文档。示例优先使用 ETag,缺失时才退回 Last-Modified;没有可用基线时拒绝接受 304。收到完整 200 后才计算摘要;实际写入基线还应等待解析与质量检查通过。生产系统需处理请求异常和受控重试,更新 304 携带的相关元数据,并将代理凭据保存在安全的密钥系统中,避免写入源码或日志。
原始字节摘要也不能充当唯一的业务变化信号。广告位、时间戳或 A/B 标记可能使 HTML 改变,但被监控的价格仍相同。应在解析后比较经过规范化的目标字段;必要时同时保存原始与规范化摘要,并记录解析器版本。若来源提供文档化的变更流或 API,优先使用这些明确接口,而不是猜测网页结构。
5. 核对变更、缺口和疑似删除
200 响应即使内容不同,也应通过模式校验后才能覆盖已接受数据:实体 ID 是否正确、必需字段是否齐全、币种和单位是否匹配、字段类型是否合理、来源时间戳是否可信。保留原始观测以供审计,再生成字段级差异。字段缺失不一定等于商品下架;它可能是同意页面、渲染不完整、重定向、地区不符或解析器回归。异常应待检查,上一条有效观测则要标明其数据年龄。
404 和 410 是有关一次请求的证据,不应立即触发删除。应在有界的稍后时间,用相同地区、语言和访问语境复核,同时检查重定向及官方列表或 API 状态。确认真正移除后,保存带有最后出现时间与复核证据的墓碑记录。目录类来源还需对账实体集合:分类页未变,不代表每个详情页都未变;列表重排也可能造成重复观测。
关于如何区分真实页面更新与地区噪声,可阅读《网站变更监控中的代理应用》。涉及多页采集时,还需单独验证分页完整性与续页信号。增量请求只能优化已经正确的采集流程,不能修复不完整的页面清单。
6. 遵守来源限制并衡量真实收益
安排任务前,应检查发布方条款、访问授权,以及目标路径适用的《机器人排除协议》规则。robots 指令是爬取控制信号,不等于访问许可。适当标识客户端,限制并发,设置退避,并为 403 或 429 制定停止规则。若响应提供 Retry-After,应按其要求暂停。不能通过切换网络出口忽视来源的拒绝或限流。
需要持续监测:覆盖率(已接受实体相对预期清单)、最近有效观测的数据年龄、304 占比、每次有效更新传输的字节量、解析拒绝率、429 比例以及市场语境不匹配率。按来源和语境分组观察;304 占比高可能意味着高效验证,也可能意味着状态键过于宽泛。定期对小样本做完整重抓,检验验证器与字段提取是否仍符合实际。记录抽样方法和例外,避免宣传未经证实的成功率。
Arcvenza 的Crawler Console用于配置、启动和监控爬取任务,可提供运营层面的可见性;基线存储、条件请求、解析器测试与变更定义仍由采集系统负责。先在少量获准来源上证明基线和语境键正确,再依据新鲜度与质量指标逐步扩展。
可靠的增量采集,本质上是有证据约束的状态机:观测获准访问的表示,完成验证,在正确语境中比较,只有证据支持时才输出更新。HTTP 304 可以减少不必要的传输,却不能替代完整覆盖、准确解析和负责任的来源访问。
官方标准与技术文档