




















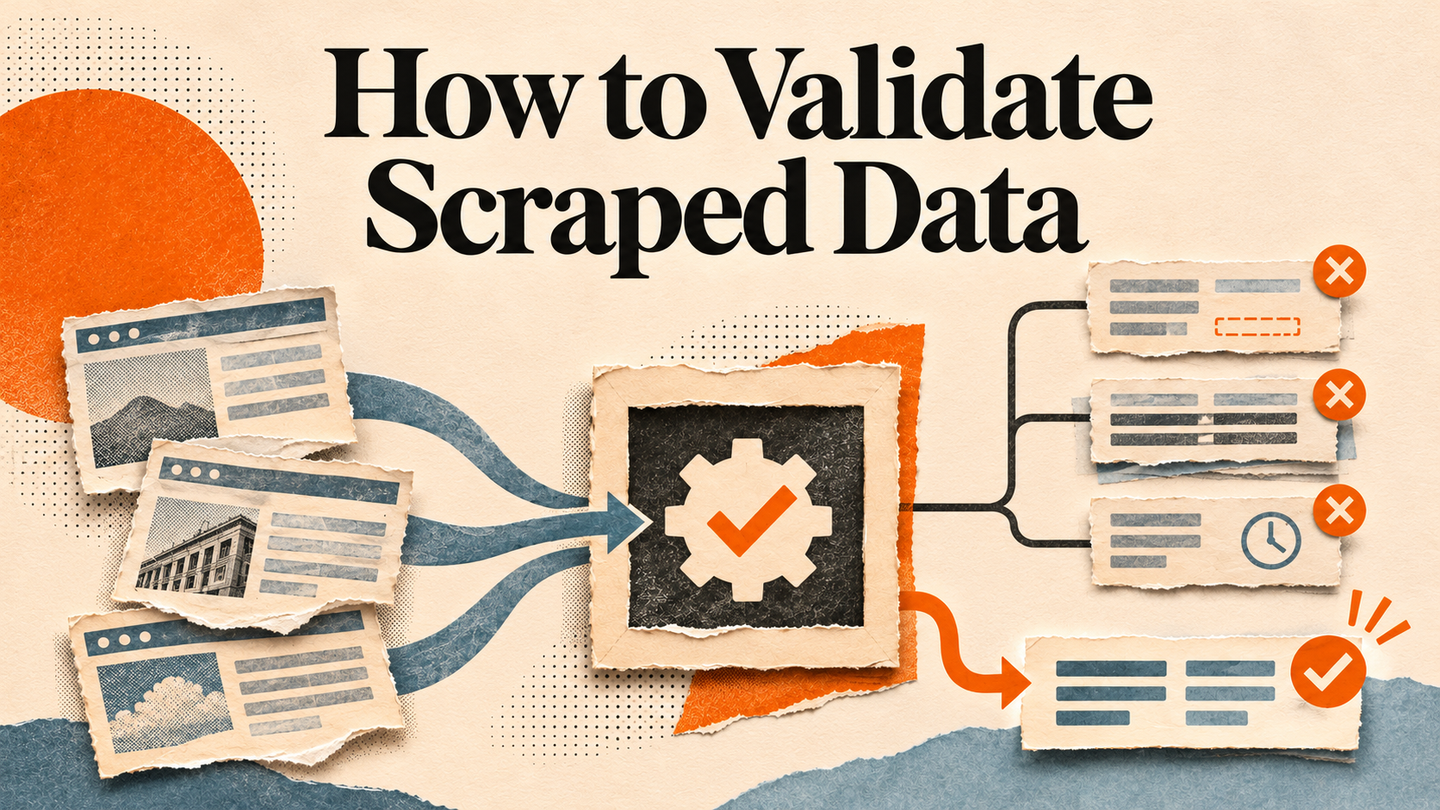
HTTP 请求成功,只代表获得了一次观测,并不代表得到了可靠的数据集。爬虫即使对每个 URL 都收到 200 OK,仍可能抓到同意页面、错误地区的内容、不完整的末页、重复记录,或把价格解析成错误币种。数据质量必须在“网页观测”转化为“可发布记录”的环节判断。
TL;DR:先按来源与市场定义验收契约。逐条检查结构和业务含义,再对账已接受实体与有依据的预期清单,使用真实观测时间衡量新鲜度,并保存足以重现争议数值的来源证据。失败记录进入隔离区,不能伪装成零值或删除。代理与爬虫工具协助获取和追踪观测;是否发布由数据管道决定。
1. 定义可信记录的单位与验收契约
先确定要回答什么问题,再设计验证器。公开商品目录的记录单位可能是“商品 × 卖家 × 规格 × 配送市场 × 币种”的报价;招聘站点则可能是职位及其雇主、地点和状态。URL 往往不是稳定的实体键:同一商品可能有多个 URL,同一 URL 也可能因地区或会话呈现不同报价。
验收契约应写明允许访问的来源路径、实体键、必需字段、类型、有效范围、目标市场与语言、观测窗口,以及缺失值的处理方式。还要规定本次运行怎样才算“完整”。若来源提供有文档的 API 或导出,优先采用其字段和分页契约。若依赖 HTML,则记录选择器或解析器版本,并将少量人工核对样本与页面实际呈现作对照。
把“观测状态”与“业务值”分开。被拒绝的请求、解析器返回空结果、真实的零价格,是三种不同状态,不能都写成 0 或 null。暂时无法访问的商品不等于商品已被删除;翻译后的价格也不一定能与原币种直接比较。应在数据契约中明确定义,避免下游分析人员凭空猜测。
2. 先验证结构,再验证业务含义
JSON Schema 2020-12 官方规范可将必需属性、类型、范围和模式表达为带版本的契约,但它验证的范围比“事实正确”窄。一个记录可以完全符合 Schema,却对应错误商品或市场。因此,结构校验之后还需业务校验:币种是否匹配店铺、标识符是否属于所见实体、库存文字有无明确解释、价格单位是否符合来源约定。
下表可用于定位问题。真正的发布阈值应由来源契约和业务误差预算决定,不存在对所有网站都适用的“好数据百分比”。
| 验收关口 | 应保存的证据 | 常见失败 | 处理方式 |
|---|---|---|---|
| 传输与语境 | URL、状态码、最终 URL、地区、语言、时间 | 200 实际是验证页或错误市场 | 隔离;检查出口与页面身份 |
| 记录结构 | Schema 版本、必需字段、类型、范围 | 缺 ID、负价格、时间格式错误 | 按字段记录原因并拒收 |
| 业务语义 | 来源标签、单位、币种、实体匹配 | 抓到其他规格或配送区域的价格 | 复查解析器或语境,不静默纠正 |
| 数据集覆盖率 | 预期清单依据、已接受 ID、重复项 | 末页缺失或 ID 重复 | 标记本次运行不完整,检查分页 |
| 新鲜度与血缘 | 观测时间、来源更新时间、响应摘要、解析器版本 | 旧缓存或无法追溯的数值 | 暂缓发布或明确标为过期 |
下面的 Python 示例只验证已经提取出的少量记录。若使用 date-time 格式检查,请安装 jsonschema[format];Python `jsonschema` 官方文档指出格式验证默认可选,部分格式还依赖额外包。示例中的记录与预期清单均为假设,不是 Arcvenza 实测结果。
from jsonschema import Draft202012Validator, FormatChecker

SCHEMA = {
    "$schema": "https://json-schema.org/draft/2020-12/schema",
    "type": "object",
    "required": ["id", "url", "market", "price_minor", "currency", "observed_at"],
    "properties": {
        "id": {"type": "string", "minLength": 1},
        "url": {"type": "string", "format": "uri"},
        "market": {"const": "US"},
        "price_minor": {"type": "integer", "minimum": 0},
        "currency": {"const": "USD"},
        "observed_at": {"type": "string", "format": "date-time"},
    },
    "additionalProperties": False,
}

records = [
    {"id": "A-1", "url": "https://example.com/a-1", "market": "US",
     "price_minor": 12999, "currency": "USD", "observed_at": "2026-11-16T10:00:00Z"},
    {"id": "A-2", "url": "https://example.com/a-2", "market": "US",
     "price_minor": -1, "currency": "USD", "observed_at": "2026-11-16T10:00:00Z"},
]
expected_ids = {"A-1", "A-2", "A-3"}  # Same-source, same-market inventory

Draft202012Validator.check_schema(SCHEMA)
validator = Draft202012Validator(SCHEMA, format_checker=FormatChecker())
accepted, rejected, seen = [], [], set()
for record in records:
    errors = sorted(validator.iter_errors(record), key=lambda e: str(e.path))
    if errors:
        rejected.append((record.get("id"), [e.message for e in errors]))
        continue
    if record["id"] in seen:
        rejected.append((record["id"], ["duplicate ID in this run"]))
        continue
    seen.add(record["id"])
    accepted.append(record)

accepted_ids = {r["id"] for r in accepted}
coverage = len(accepted_ids & expected_ids) / len(expected_ids)
missing_ids = sorted(expected_ids - accepted_ids)
print({"accepted": len(accepted), "rejected": rejected,
       "missing_ids": missing_ids, "coverage": coverage})
示例会拒收负价格,并发现预期 ID 缺失,但它无法断言其余记录在事实层面正确,也无法独自决定是否发布。金额计算应明确币种,使用最小货币单位的整数或合适的十进制表示。观测时间应使用带时区偏移的 RFC 3339 时间戳,以便跨地区计算数据年龄。
3. 对账覆盖率,不制造“完整”的假象
覆盖率是已接受数据集的性质,不是 HTTP 请求数量。设 E 为相同来源、查询、地区和观测窗口下,有依据的预期实体 ID 集合;A 为已接受的唯一 ID。基础覆盖率可写作 |A ∩ E| / |E|。只有 E 的来源被记录且不为空,这个数才有意义。站点地图、官方 API 总量、获许可的导出或独立核验的样本都可能帮助建立分母,但各有局限。
对于持续变化的目录,页面显示的总量可能在抓取过程中变化。不能只因为拿到 100 页中的 98 页就宣称“98% 完整”,还必须检查每页记录数、列表重排和总量是否使用同样的筛选条件。应记录翻页链接或游标、唯一 ID、重复率及明确的结束信号。最后一次请求收到 200 不等于已经到达末页;解析器产出零记录也可能意味着布局改变,而非目录为空。
按地区、类别、来源和运行批次拆分覆盖率。全局平均值可能掩盖整片地区或整类商品的缺口。保存缺失 ID 列表及每个排除原因;若分母未知,就同时报告“覆盖率尚未建立”和已观察数量,不要虚构百分比。电商数据采集指南进一步说明为何地区和币种语境应随每条观测保存。
4. 用有效证据的时间衡量新鲜度
条件允许时至少记录三个时间:系统发起请求的时间、记录通过验收的时间,以及发布方声称底层对象更新的时间。这是三个不同的时钟。刚抓到的网页可能仍显示旧价格;来源的 updated_at 可能滞后于页面;符合缓存规则的响应,也可能不符合业务新鲜度要求。应在契约中定义具体目标,并从最近一次有效观测而不是最近一次尝试请求计算数据年龄。
使用带时区的时间戳,并保留原始偏移。RFC 3339 定义了互联网时间戳表示;转换为 UTC 有利于比较,但原始来源字符串仍应保留以供审计。注意系统时钟偏差、来源时区,以及名为“更新时间”却实际表示发布时间的字段。若商品暂时消失,不能把一次失败请求时间当作新的更新时间;应记为“最后见到时间”,等待复核。
新鲜度还取决于业务语境。每周发布一次的政府资料和快速变化的零售库存,应有不同的采集频率和告警条件。可定期对小样本做独立完整抓取或人工核验,确认“未变化”和“新鲜”的标签仍符合来源事实。失败检查是一件质量事件;它会让上一条可信记录变老,而不是把其年龄清零。
5. 保存来源证据,让异常可以重现
对每个已发布字段,都应能追溯到一次具体观测:规范来源 URL、获准重定向后的最终 URL、UTC 观测时间、地区与语言、响应状态、请求语境、原始响应或其持久存储地址、内容摘要、解析器与 Schema 版本、验收结果。只保存有权保留的数据,并按来源要求设置访问控制。哈希可用于证明已保存工件未被改动,却不能证明来源真实,也不能证明解析正确。
运行 ID 和原因代码能把记录与采集尝试关联起来。例如 wrong_market、missing_required_field、duplicate_id、challenge_page、stale_baseline,比笼统的“抓取失败”更利于排障。保存少量已接受和被拒绝的可复现页面样本,用于解析器回归测试。更换解析器版本时,先在相同存档页面上比较新旧输出,再决定是否启用。
来源证据也能避免错误归因。住宅代理出口可以帮助观察特定市场的公开页面,但不能证明所见价格代表该市场所有买家。若邮编、币种、规格、会话或配送条件会影响页面,就应把它们与观测一起保存。调查异常变化时,需要重现同样的语境。
6. 给整个数据集设置发布门槛
发布决定应综合多个关口:结构或业务语义失败的记录不得进入正式数据;必需来源或市场片区、翻页完整性未通过时,本次运行应暂缓;过期记录应依契约标注或排除;未解决的 403、429 和验证页不能算作有效数据。每个关口都要报告分子、分母、阈值和例外。阈值需围绕业务决策及实际来源表现设定,不能从某篇博客复制一个通用数字。
最后,遵守发布方条款、访问授权和适用的《机器人排除协议》规则;robots 控制并不授予访问权。限制并发,并在拒绝或限流时停止或退避。诚实的数据集应明确标出未知项。与其把成功请求拼成虚假的“完整性”,不如发布较少但证据充分的记录。
官方标准与技术文档